Article mis à jour le 8 août 2026.
Il y a quelque chose qui me gêne dans une partie du discours actuel sur le GEO : pour expliquer la rupture, on simplifie parfois tellement le SEO d’hier qu’on finit par inventer un adversaire commode. Le SEO aurait consisté à trouver un mot-clé, décliner sa longue traîne, publier une page et attendre le classement. Puis seraient arrivés ChatGPT, Gemini ou Perplexity, qui nous auraient enfin appris à partir des intentions, des questions et des besoins réels de l’utilisateur.
Cette histoire est séduisante. Elle est aussi trop courte. Les équipes SEO les plus matures travaillent depuis longtemps la sémantique, l’intention, les sujets et les parcours. Et les bonnes stratégies de contenu n’ont évidemment pas attendu les moteurs génératifs pour s’intéresser aux problèmes, aux objections et aux critères de décision des acheteurs. Lorsque j’étais Directrice Marketing Opérationnel pour le groupe Euler Hermes, aujourd’hui Allianz Trade, les équipes marketing les plus avancées raisonnaient déjà en besoins clients, niveaux de maturité, parcours de décision et contenus adaptés aux différentes étapes du funnel. Je ne prétends pas, pour autant, décrire ici leur stratégie SEO : ce n’était pas mon périmètre et je ne sais pas précisément comment elle était menée. Cet exemple m’intéresse pour une seule raison : il rappelle que partir de l’acheteur n’est pas une invention du GEO
Le GEO n’a pas inventé l’intention de recherche
La longue traîne a toujours eu une utilité évidente : plus une formulation devient précise, plus elle révèle du contexte. « Assurance-crédit » ne dit presque rien du problème réel. « Comment réduire le risque fournisseur lorsque trois fournisseurs concentrent 70 % de mes achats ? » fait apparaître un niveau de contrainte et de décision beaucoup plus riche.
Mais ce niveau de précision ne transforme pas, à lui seul, une pratique SEO en pratique GEO. Google travaille depuis des années à interpréter l’intention et les relations sémantiques ; les content strategists sérieux travaillent depuis longtemps les personas, objections, besoins informationnels et moments de décision. Opposer un ancien SEO réduit au mot-clé à un GEO enfin centré sur l’utilisateur crée donc une fausse rupture.
La différence devient plus nette lorsque l’on regarde non plus seulement la formulation de la demande, mais ce que fait le système avec cette demande. C’est là que le moteur génératif change réellement le problème d’optimisation.
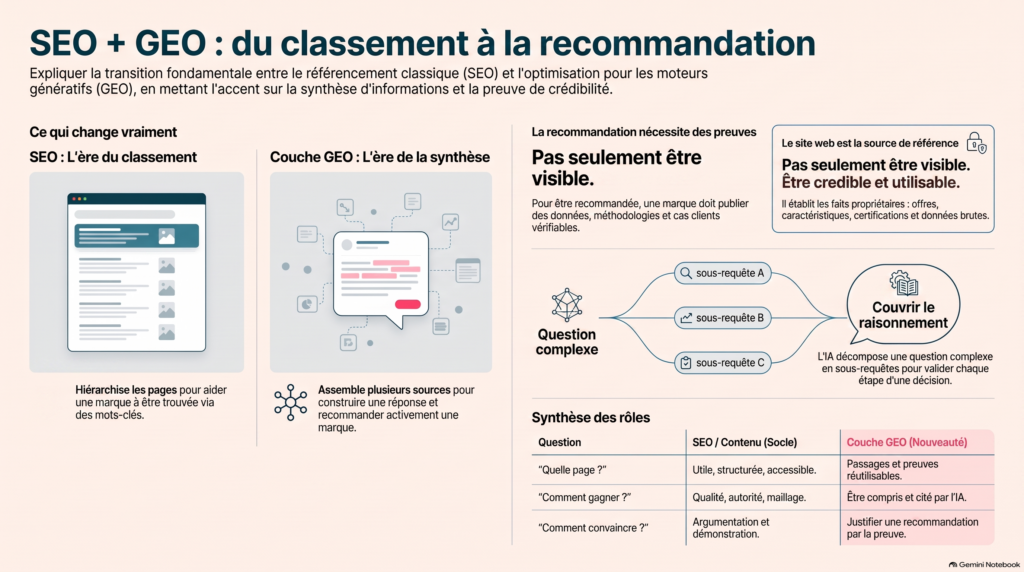
Une IA ne classe pas seulement des pages : elle construit une réponse
Dans une recherche traditionnelle, la surface visible est une liste de résultats. Même si les algorithmes comprennent bien davantage que des chaînes de caractères, le résultat proposé à l’utilisateur reste essentiellement une hiérarchie de documents. L’utilisateur ouvre, compare, recoupe et construit sa propre synthèse.
Un moteur génératif peut déporter une partie de ce travail vers la machine. Le papier académique fondateur du GEO, publié en 2024 par Pranjal Aggarwal et ses coauteurs, formalise un moteur génératif comme un système capable de reformuler une requête, de récupérer plusieurs sources, de les résumer puis de produire une réponse fondée sur ces sources [1]. Ce modèle n’est pas une description universelle de tous les produits commerciaux en 2026, mais il met le doigt sur la rupture essentielle : la réponse finale peut être construite à partir de plusieurs documents et de plusieurs passages extraits.
Cela change l’unité de compétition. Une page reste importante, mais un système peut n’en utiliser qu’un passage, une donnée, une définition, une comparaison ou une preuve. Le contenu doit donc rester excellent comme page pour un humain tout en étant suffisamment explicite localement pour qu’un fragment conserve son sens lorsqu’il est récupéré hors de son contexte.
| Question | SEO / contenu : socle toujours valable | Couche supplémentaire en GEO |
| Quel besoin traiter ? | Intention, persona, problème, étape du parcours. | Même point de départ. |
| Quelle page produire ? | Page utile, structurée, accessible et pertinente. | Penser aussi aux passages, données et preuves réutilisables. |
| Comment gagner en visibilité ? | Indexabilité, qualité, autorité, maillage, pertinence. | Être compris, récupéré, éventuellement cité ou mobilisé dans une synthèse. |
| Comment convaincre ? | Argumentation, cas clients, preuves, démonstration. | Donner au système de quoi justifier une recommandation ou une exclusion. |
| Comment mesurer ? | Positions, clics, impressions, trafic, conversions. | Ajouter fréquence de mention, citation, recommandation, exactitude et variabilité. |
Une seule question peut cacher plusieurs besoins d’information
Prenons la question : « Comment réduire mon risque fournisseur si je dépends de quelques fournisseurs stratégiques ? » Pour produire une réponse utile, un système peut devoir traiter plusieurs dimensions : mesurer la concentration, repérer les indicateurs de fragilité financière, examiner les solutions contractuelles, comprendre les options de couverture, comparer les coûts, puis adapter la réponse au secteur ou au pays.
Autrement dit, une formulation longue n’est pas seulement un « mot-clé long ». Elle peut contenir plusieurs sous-problèmes. Google documente lui-même le principe de query fan-out dans certains de ses environnements d’IA : une question peut être décomposée en sous-thèmes ou sous-requêtes avant synthèse. Karine Abbou l’utilise également dans ses frameworks de Content Jam 2026 pour expliquer pourquoi un prompt complexe crée plusieurs besoins informationnels. Il faut néanmoins garder la bonne discipline : ce mécanisme documenté dans certains produits ne permet pas d’inférer le détail interne de tous les moteurs IA.
La conséquence éditoriale est plus profonde qu’un nouveau fichier Excel de longue traîne. Au lieu de demander uniquement « avons-nous une page sur ce sujet ? », il faut aussi demander : quelles affirmations, quelles données, quels critères, quelles limites et quelles preuves notre contenu apporte-t-il aux différents morceaux du raisonnement ?
Pour être recommandé, il faut donner à l’IA des raisons de vous choisir

C’est ici, à mon sens, que le passage du classement à la recommandation change vraiment le métier du content marketer.
Pour expliquer ce qu’est une assurance-crédit, un CRM ou un cabinet de conseil, un moteur a surtout besoin d’informations exactes, compréhensibles et accessibles. Mais dès que la question devient « quelle solution est la plus adaptée à mon contexte ? », il doit arbitrer. Il lui faut des éléments permettant de comparer, d’écarter, de nuancer et de justifier.
C’est ce qu’Andy Crestodina résume avec une idée que je trouve beaucoup plus structurante que l’injonction à « écrire pour les IA » : publier les raisons de croire que l’on est le bon choix. Ces reasons to believe peuvent être des données originales, une méthodologie, des résultats clients, des comparaisons, des certifications, des limites assumées, des conditions d’éligibilité, une expertise sectorielle démontrée ou des preuves opérationnelles difficiles à contester.
Le papier GEO d’Aggarwal et al. apporte ici un signal intéressant : dans leur dispositif expérimental, ajouter des citations, des statistiques ou des quotations a amélioré certaines métriques de visibilité, avec des effets variables selon les domaines, tandis que le keyword stuffing performait mal [1]. Il serait abusif d’en déduire une recette universelle du type « ajoutez trois statistiques et vous serez cité ». La conclusion plus solide est que la présentation de l’information et la densité de preuves peuvent changer la manière dont une source est utilisée dans un système génératif donné.
Le défi éditorial se déplace donc. La question n’est plus seulement : « comment écrire une page qui répond à cette requête ? » Elle devient aussi : « Quelles preuves ai-je rendues publiques pour qu’un système tiers puisse expliquer pourquoi ma marque mérite d’entrer dans la recommandation ? »
Votre site reste central, mais il n’est plus seul à parler de vous
Une marque reste la meilleure source pour les faits qu’elle contrôle : son offre, ses capacités, ses produits, ses prix, ses certifications, ses zones d’intervention, ses équipes, ses méthodes, ses conditions commerciales. Le site est donc loin d’être dépassé. Il constitue le référentiel que la marque maîtrise.
Mais un site est aussi une source intéressée. Lorsqu’une IA doit recommander une entreprise, d’autres familles de sources peuvent apporter ce que le site ne peut pas produire seul : validation indépendante, comparaison, expérience client, réputation sectorielle, contexte réglementaire ou preuve de marché.
Muck Rack a analysé plus d’un million de liens cités dans des réponses web-enabled de variantes de ChatGPT, Gemini et Claude en juillet 2025. Le résultat le plus utile n’est pas une liste magique de domaines à viser : c’est la forte variation des sources selon le modèle, le secteur et le type de requête [2]. Les sources jugées utiles en finance ne sont pas les mêmes qu’en santé, en énergie ou en technologie. Et le rapport lui-même rappelle que ces comportements sont amenés à évoluer.
C’est pourquoi une stratégie de visibilité IA doit articuler sources propriétaires et validation externe. Le sujet n’est pas d’accumuler des mentions partout, mais de construire un environnement de preuves cohérent autour de la marque.
À lire aussi : Stratégie GEO : comment être cité par les IA ?
6. Il n’existe pas une visibilité IA unique
Une autre tentation consiste à chercher l’équivalent de la position Google : « Je suis numéro 3 dans ChatGPT ». Le problème est que la réponse générative est probabiliste. Elle dépend du produit, du mode de recherche, de la formulation, du contexte, du moment, des sources disponibles et parfois de l’utilisateur.
La recherche publiée par Rand Fishkin et Patrick O’Donnell en janvier 2026 est utile à cet égard. Leur expérience a collecté 2 961 réponses produites auprès de 600 volontaires, sur 12 prompts et plusieurs environnements IA. Elle met en évidence une forte instabilité dans les recommandations de marques et de produits, tout en montrant que certaines marques sont beaucoup plus récurrentes que d’autres [3].
La conséquence est méthodologique : une capture d’écran n’est pas une mesure. Pour savoir si une marque progresse réellement, il faut répéter des prompts, documenter les variantes, comparer plusieurs environnements, suivre les résultats dans le temps et séparer mention, citation et recommandation.
Pour un premier diagnostic simple de ces écarts, il faut surtout répéter les tests et ne jamais prendre une seule réponse pour une vérité stable.
Pour passer au diagnostic : 8 questions pour tester sa marque sur ChatGPT
7. Alors, à quoi sert encore la longue traîne en GEO ?
À beaucoup de choses. Les formulations longues révèlent des situations que les requêtes génériques masquent : budget, géographie, taille d’équipe, secteur, contraintes réglementaires, compatibilités, niveau de risque, maturité, délais ou critères d’exclusion.
Elles sont donc précieuses pour comprendre le langage réel des acheteurs et faire émerger des problèmes suffisamment précis pour produire de meilleurs contenus. Ce qui change, c’est ce que l’on fait ensuite de cette matière.
Le travail ne consiste pas à transformer chaque formulation conversationnelle en nouvelle page ou en nouveau mot-clé. Il consiste à identifier tout ce qu’une bonne réponse doit établir : diagnostic, critères, alternatives, preuves, limites, sources, conditions de réussite et, lorsque la question est transactionnelle, raisons de recommander une option plutôt qu’une autre.
Le bon content marketing n’est pas obsolète. Il est devenu le socle.
Le GEO ne demande pas aux équipes marketing d’oublier vingt ans de stratégie de contenu. Comprendre l’acheteur, ses intentions, ses objections, ses critères et son parcours reste indispensable. Les équipes qui faisaient déjà ce travail correctement ne repartent pas de zéro.
Elles doivent en revanche ajouter une nouvelle question : notre système de contenus et de preuves fournit-il suffisamment d’informations pour être retrouvé, compris, combiné avec d’autres sources et utilisé correctement dans une réponse, voire dans une recommandation ?
Cette question change la manière d’écrire, mais aussi la manière de prioriser les contenus, les études, les cas clients, les pages produits, les données propriétaires, la documentation et la présence externe. Elle oblige également à mesurer autre chose que le trafic.
Et elle ouvre immédiatement une deuxième question business : que se passe-t-il une fois que l’IA a recommandé votre marque ? La visibilité ne vaut que si le reste du parcours sait reprendre le relais.
Article complémentaire : GEO, SEO et SEA : que se passe-t-il après une recommandation IA ?
Références
[1] Pranjal Aggarwal et al. — GEO: Generative Engine Optimization. KDD 2024. Architecture représentative des moteurs génératifs, récupération multi-source, métriques de visibilité et expérimentations GEO. https://arxiv.org/abs/2311.09735
Portée utilisée : résultats expérimentaux à ne pas généraliser comme règles universelles des produits commerciaux actuels.
[2] Muck Rack — What Is AI Reading? Generative Pulse 2025. Analyse de plus d’un million de liens cités par des variantes web-enabled de ChatGPT, Gemini et Claude ; données collectées en juillet 2025. https://muckrack.com/blog/2025/08/13/what-is-ai-reading/
Portée : utilisée pour documenter la variation des sources selon le modèle, le secteur, la requête et la récence.
[3] Rand Fishkin & Patrick O’Donnell / Gumshoe — AIs Are Highly Inconsistent When Recommending Brands or Products. SparkToro, 27 janvier 2026. 600 volontaires, 12 prompts, 2 961 réponses enregistrées. https://sparktoro.com/blog/new-research-ais-are-highly-inconsistent-when-recommending-brands-or-products-marketers-should-take-care-when-tracking-ai-visibility/
Portée : utilisé pour justifier la répétition des prompts et l’abandon d’une logique de “rang IA” unique.
[4] Responsive & Adience — Inside the Buyer’s Mind: What Shapes B2B Decisions Today. Étude de juillet 2025 auprès de 350 acheteurs B2B impliqués dans des sélections stratégiques de fournisseurs. https://www.responsive.io/blog/2025-b2b-buyer-decisions-report
Portée utilisée : contexte sur la recherche autonome, la montée de GenAI dans la découverte et l’importance persistante de l’expertise et des preuves dans la décision.
[5] Karine Abbou – Workshop Content Jam 2026. Présentation sur query fan-out, Source Stack, entités et content engineering ; inclut des contributions et citations d’Andy Crestodina.
Portée utilisée : utilisée comme cadre opérationnel et non comme preuve indépendante lorsque l’étude sous-jacente n’est pas explicitement vérifiée.